viernes, 1 de mayo de 2020

Poniéndonos las Pilas!!! - Todo un hervidero II (Mayo 2020)

Hola a todos:
El miércoles pasado (29 de abril) tuvimos nuestra primera sesión virtual (no será la última). Fue como siempre una sesión intensa en la que planteamos la posibilidad de terminar nuestro proyecto. Es decir, plantearnos todo un reto: 

Escribir la comunicación.

El motivo de ello no es otro, que los proyectos PIIISA en la EEZ de este año continúan. 

Tenemos hasta el 27 de mayo para presentar nuestra comunicación. 

Por tanto nos pondremos las Pilas para ello. 


A la reunión asistimos: Marta, Marina y Nicolás. Junto a vuestro tutor Ramón. Tras un serio “brainstorming”, decidimos que podíamos llevar a cabo un manuscrito (en recursos, tenemos varios ejemplos de manuscritos anteriores que pueden ayudaros a entender que no andamos lejos: 2014, 2015 y 2016).
Importante: El pasado miércoles tomamos la decisión con cuál de los títulos que os proponía nos íbamos a sentir más cómodos en la comunicación.


Efectivamente, lo sugirió Marta (o Marina, no sé) y creo que es el adecuado:
“How to know if a bacteria contains CRISPR elements?”
Porque eso es realmente lo que hemos vislumbrado en este proyecto. O no???

(i)   Sabemos qué son las siglas CRISPR.
(ii)  Sabemos qué herramientas se usan para descubrirlos.
(iii) Sabemos interpretar la información que dan.


 Así que manos a la obra:
Estos días iré subiendo al blog. Distintas imágenes que formaran parte de la comunicación y que quiero que escribáis la leyenda de las figuras (lo que significan). 

A modo de ejemplo, probablemente la primera figura de la introducción de nuestro trabajo:


Figure 1: Diagram of a CRISPR-cas system. The leader sequence, between 20 and 534 nucleotides in length, contains the promoter sequence for transcription of the CRISPR array. The repeats (diamonds) are between 21 and 50 nucleotides in length (mean of 31 nt), while the spacers (colored squares) are between 17 and 84 nucleotides (mean of 36 nt). In the vicinity of the array, the presence of Cas genes (in white) is frequent.

Para esto último, escribir la leyenda de las figuras que tengamos en el trabajo, he dividido al grupo en tres parejas, ya que no todos pudimos estar en la reunión el pasado miércoles:
Pareja A: Marta y Maria
Pareja B: Marina y Daniel
Pareja C: Nicolás y Sara.

Contactad entre vosotros!!!!.  En las próximas entradas, incluido los correos os enviaré la información para ello.
¿Qué es lo que tenéis que hacer de momento?

Repasar el blog de atrás a adelante y empararos de todo lo que hemos hecho (sobre todo en aquellas sesiones tan intensas) y recordarlo.


Por último, y lo subrayo. Nuestra comunicación tiene un apartado (echad un vistazo en recursos y veréis lo que pusieron otros alumnos otros años):

My OWN IDEAS
Tenemos una nueva cita en breve!!!!
AUPA CRISPR team!!!

En ella cada uno tendrá que expresar su experiencia en este proyecto.

jueves, 23 de abril de 2020

CONFINADOS PERO ACTIVOS - Todo un hervidero (Abril 2020)

Hola a todos:
Tras un tiempo confinados, adaptándonos y tomando conciencia de la nueva realidad, no deja de ser curioso comprobar que tenemos todo el tiempo del mundo y al mismo tiempo nos falta tiempo para las múltiples tareas "on line" en las que andamos embarcados...


Y es que en estos tiempos el mundo parece un hervidero, y la ciencia incluso más que cualquier otra labor. De hecho y como habréis oído en las noticias varios centros de Investigación en Biomedicina, en todo el mundo, se han puesto en la labor de adaptar sus investigaciones a incrementar el conocimiento URGENTE sobre la biología, clínica, desarrollo de tecnologías etc. sobre este coronavirus, el SARS-cov2. En España todo este esfuerzo está siendo coordinado por el Instituto de Salud Carlos III.


Y como no podía ser de otro modo, el mundo de los CRISPR tampoco se está quieto...
En este sentido, seguro que habéis escuchado que uno de los aspectos críticos en relación a esta pandemia es la falta de información sobre la expansión del virus SARS Cov 2 en la población. Y ello es debido a la dificultad de hacer test fiables, rápidos y a un buen número de individuos de la población.

 Fuente: Diario La Opinión de Málaga. Toma de muestras para el análisis del SARS cov-2.

Os animo a que leáis esta noticia aparecida en varios medios hace unos días: Una técnica experimental diagnostica la covid en 40 minutos.

 Fuente: diario El País.


Investigadores de EE UU están desarrollando un test rápido para la covid-19 que puede diagnosticar una infección en unos 40 minutos. La nueva tecnología  es aún experimental y se basa en la revolucionaria técnica de edición genética CRISPR. Fuente El País 21/Abril de 2020.
Aunque este test todavía requiere de una mayor investigación y desarrollo, me gustaría que leyéramos la noticia en profundidad y de nuevo la relacionáramos con la investigación de nuestro proyecto. Premio, al primero que me responda… a esta y sobre todo a la anterior entrada!!!
Siempre es bueno, relacionar la investigación que estamos haciendo con su posible y real aplicabilidad. Un ejemplo más de la "serendipia" en Ciencia.

Aupa, CRISPR Team!!!!
Que con sólo un último esfuerzo podríamos cerrar nuestro proyecto!!!!

jueves, 19 de marzo de 2020

Conviviendo con la actualidad (Marzo 2020)

Hola a todos:
Vaya tiempos!!! 


Parece mentira que algo que solo mide 20 kilobases y apenas unos 8 genes (ver figura 2), tenga tal capacidad de cambiar nuestras vidas… . Pero la tiene, la verdad es que la tiene… .


Figura 2: Estructura genómica de distintos coronavirus Humanos. Los nombres de cada gen están indicados. Genes específicos de cada género están en colores claros. Enjuanes et al. 2016. Advances in Virus Research.

Estamos inmersos en una montaña rusa donde las pautas que servían hace tan solo unos días están cambiando rapidísimamente. Y es que nos enfrentamos a algo muy serio, que hace muy complicado ponerse enfermos en la actualidad (especialmente si son nuestros mayores los afectados). Por tanto, cuidaros mucho. Apoyad y apoyaros en todo vuestro entorno. Aprenderemos mucho de esta experiencia, sobre cómo vivir aislados, pero más en contacto que nunca.
Desde luego que vivimos una época excepcional, y como tal debemos de enfrentarnos a ella. Si lo pensamos, y volviendo a nuestro tema común, a nuestro proyecto, a lo mejor hemos tenido doble suerte con este proyecto CRISPR.
Suerte en el hecho de que para participar en este proyecto solo necesitamos:
- Nuestro ordenador.
- Internet.
- Nuestra cabeza.
Respecto a lo último, estoy seguro de que si recordamos un poco, estamos más preparados que nunca para terminar y dar la guinda a este proyecto. Con independencia de cuando tengamos la oportunidad de presentarlo, cosa que no dudéis. Se nos presentará. ¡¡¡Ya veréis!!!
Volviendo a nuestra tarea. Es importante avanzar para que de esta manera cuando volvamos no empecemos de cero.
Si miráis la última entrada, os dije que íbamos a "buscar" CRISPR elements en un genoma no descrito todavía. El genoma de Vibrio vulnificus VV5. En seguida lo recibiréis en vuestro correo. Descargarlo de vuestros ordenadores.
El genoma tiene un tamaño de 5.226.436 nucleótidos (lo podéis abrir desde el Clone Manager). ¡¡¡Está esperando que lo analicemos!!!
Repasad vuestras notas. Quiero que me digáis y lo apuntéis en el blog. Quiero que discutáis por Skype las siguientes cuestiones:
- ¿Hay elementos CRISPR?
- ¿Cuántos?
- ¿Dónde se localizan? ¿Cuáles son sus coordenadas?
Premio al que inserte pantallas en las entradas.

A partir de aquí se generarán nuevas preguntas. ¿Os parece bien que nos sincronicemos semana a semana?
Ánimo, que más pronto que tarde nos veremos de nuevo.

Un saludo y un abrazo.

martes, 11 de febrero de 2020

Noticias y actualidad

El pasado Lunes 10 de Febrero se ha publicado en la prensa esta noticia…


Enlaces varios:
https://elpais.com/elpais/2020/02/10/ciencia/1581359329_317929.html
https://www.mundiario.com/articulo/sociedad/autorizan-modificacion-genes-40-embriones-humanos-cataluna/20200210230024175335.html

Os recomiendo que leáis en detalle esta noticia.

Embriones Humanos (La Vanguardia)

¿Por qué está relacionada con nuestro blog?
¿En qué está basada esta forma de edición génica que proponen en este proyecto?

Como toda investigación siempre es importante que conozcamos de primera mano las posibles repercusiones (aunque sean lejanas) de nuestra propia investigación.

Un saludo y Aupa CRISPR-team.
Nos vemos en breve.

martes, 4 de febrero de 2020

Preparando la nueva cita

Como ya os comenté, ya hemos decidido qué genoma investigar.
Se trata de una colaboración que tenemos con el grupo de la catedrática de Microbiología Carmen Amaro de la Universidad de Valencia.


Carmen es especialista en el estudio de la interacción patógeno/hospedador utilizando el sistema de Vibrio vulnificus y la Anguila como modelo.

Vibrio vulnificus (Sociedad Española de Microbiología)

El genoma que vamos a analizar, no está todavía publicado y vamos a buscar la presencia de sistemas CRISPR en dicho genoma. El aislado se denomina VV5.

La nueva sesión, la dedicaremos por entero al estudio de este genoma!!!!
Y recordaremos y ahondaremos en el estudio de la herramienta CRISPR-Target: 

Aupa equipo, ya estamos cerca.

Estas son las fechas clave en la Organización de nuestra investigación.

PIIISA 2019/2020 en la Estación Experimental del Zaidín
Fechas clave:

1ª sesión:      27/11/2019
2ª sesión:      29/01/2020
3ª sesión:      29/04/2020

Congreso en la EEZ: Miércoles, 13 de mayo de 2020
Congreso General: Viernes, 22 de mayo de 2020

¡¡¡Una nueva sesión adicional!!!  ¡¡¡Este mes Febrero!!!  ¡¡¡ nos espera!!!!


Vamos a entender como las bacterias (en este caso V. vulnificus VV5) luchan frente a los virus que las atacan…

Experiencias con el clone manager, y con crispr-finder y con crispr-target…

¡¡¡De nuevo la sensación de estar exhaustos!!! Y es que … ¡¡¡vaya proyecto!!!.

Momentos de la mañana del pasado miércoles 29 (I)

Pasamos de la sorpresa, a la contra-sorpresa, al cansancio, al no me entero de nada, al me entero de todo… y todavía nos quedan desafíos… aunque nos hacemos mayores… ¿no?

Momentos de la mañana del pasado Miercoles 29 (II)

Si repasamos mentalmente lo que hemos hecho, no parece mucho pero si parece mucho … . Así:
(i) Gracias al clone manager:
-Ya sabemos mirar una secuencia de DNA de muchas maneras distintas:
-Desde arriba (dirección 5’ 3’).
-Desde abajo cadena complementaria (y de nuevo dirección 5’-3’).
-Encontrar las verdaderas regiones repetidas y no. Su equivalente complementario.

Imagen 2: Herramienta “invert”

-Aprehender bien lo que significa las siglas ORF. Que dan lugar a cadenas de aminoácidos que permiten una identificación precisa de lo que tenemos entre manos.

Imagen 3: Herramienta ORF search….

(ii) Que en lo que a secuencia de ADN se refiere dos cosas nos definen un locus CRISPR:
-El tándem de las secuencias repetidas (con sus spacers!!!!).
-El conjunto de genes cas asociados!!!

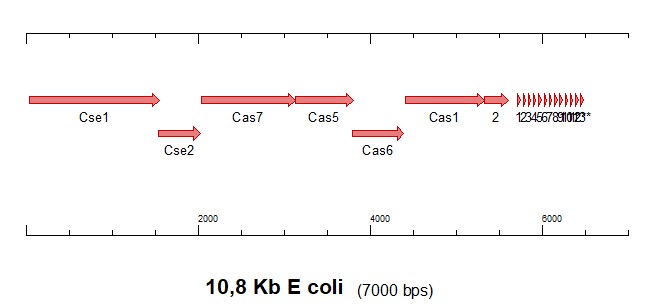
Imagen 4: Determinantes genéticos que nos definen un locus CRISPR

Todo ello nos lleva a unos spacers concretos que son algo así como el record de infecciones que han tenido lugar en una determinada especie de bacteria.

La identificación de los elementos CRISPR se realiza mediante:
Crispr finder en sus dos versiones. Ello nos permite dado un genoma determinado, encontrar dónde se encuentran.

Tenemos cuatro genomas a “investigar”:

Genoma 1: Lactobacillus paracasei strain LC355 (In Atlas of Oral Microbiology, 2015)

Genoma 2: Saccharolobus solfataricus strain P1 (In http://www.sulfosys.com/sulfolobus-solfataricus.html // Federal Ministry of Educational Research (Germany).

Genoma 3: Thermococcus chitonophagus (Imagen obtenida por K.O.Stetter & R.Rachel, Univ.Regensburg).

Genoma 4: Thermodesulfovibrio yellowstonii (Henry et al. 1994 Arch Microbiol. Jan;161(1):62-9).

Os animo a que buceeis por internet y busquéis aspectos de la biología de estos microorganimos. De donde se han aislado, que características tienen, etc…
Como os digo, debemos de confirmar y entender que los genomas que vamos a estudiar contienen:
Lactobacillus paracasei strain LC355. Un array sin proteínas
Saccharolobus solfataricus strain P1. 8 arrays confirmados y 5 sistemas crispr distintos
Thermococcus chitonophagus. 8 arrays y 5 sistemas crispR
Thermodesulfovibrio yellowstonii 5 arrays y 5 sistemas crispr

Inicialmente hay que subir los genomas a esta base de datos:
https://crisprcas.i2bc.paris-saclay.fr/

Para después lanzarle la pregunta de dónde están sus sistemas crispr.


Probad los distintos genomas y comentad lo que sale. Preguntaros y recordar el cómo entre vosotros y a través del Blog. Practicad con el clone manager e identificar las regiones conteniendo estos sistemas…

viernes, 13 de diciembre de 2019

Aprendiendo a identificar Sistemas CRISPR (III)

Si ya hemos practicado un poco con las secuencias anteriores, deberíamos entender que una secuencia de nucleótidos precisa tiene un gran valor identificativo. Por ello, podemos deducir que gran parte del manejo del programa (Clonemanger) se basa en buscar secuencias concretas, alinearlas de manera parecida, etc.  Y esas son herramientas que nos ayudarán a definir y entender cómo se logra encontrar un sistema CRISPR en una secuencia de nucleótidos,  que como todos sabemos se trata de:  
“Clustered Regularly Interspaced Short Palindromic Repeats” 

O sea, grupos de secuencias cortas (20-40 nt) repetidas generalmente palindrómicas interespaciadas de manera regular (a distancias entre 30-70 nt).

Recordando, atendiendo y practicando las explicaciones del pasado Jueves 5 de Diciembre

Para identificar de manera rápida este tipo de “estructuras” en una secuencia de DNA existe una página web denominada: crispr finder (https://crispr.i2bc.paris-saclay.fr/Server/). Os animo a que entréis:

Y subáis el documento que tenéis en la carpeta 2-E coli denominado E coli.txt (que “pesa” 4596 KB). Y “clickeis” en Find crispr
Os debe de salir algo así: 


Que debemos saber (y recordar) qué significan:


Con esta información deberíamos de saber, crear y modificar un documento de clone manager. De tal manera que partiendo de:
Una secuencia de este tipo:
 La convirtamos inicialmente en una secuencia de este tipo: 
Para ello habrá que utilizar la herramienta add feature seleccionando en cada caso la secuencia que queremos “dibujar”. En este caso deberéis de ayudar a los que no estuvieron, y hacer un poco de memoria de cómo lo hicimos ese Jueves, clave!!! … (consultar el tutorial del programa por si sirve de ayuda, usad el blog, cargarlo de preguntas, etc… ).


Finalmente, acompañando a estos sistemas repetidos, casi siempre se encuentran grupos de genes asociados, los denominados genes “Cas”. El clone manager nos va a permitir identificarlos, “dibujarlos”, definirlos y en resumen entender en qué consisten. 

Se trata de que debemos de convertir esta información:

En esta otra:

Donde se identifican los marcos abiertos de lectura (ORFs) que codifican las proteínas que acompañan el elemento CRISPR (con 13 repeticiones directas) y que hacen funcional todo un sistema de defensa inmune en bacterias.

Es sólo (y no tan sólo, soy consciente) de ponernos un rato y “entender” toda la información extraíble de una mera secuencia de cuatro letras: la A, la T, la C y la G… .
Ánimo que veréis como podéis (podemos). Activemos el blog con comentarios/preguntas, que estoy seguro que no sólo hay una sino mil….
Ya tenemos tarea!!!!...

Entradas más visitadas