jueves, 19 de marzo de 2020

Conviviendo con la actualidad (Marzo 2020)

Hola a todos:
Vaya tiempos!!! 


Parece mentira que algo que solo mide 20 kilobases y apenas unos 8 genes (ver figura 2), tenga tal capacidad de cambiar nuestras vidas… . Pero la tiene, la verdad es que la tiene… .


Figura 2: Estructura genómica de distintos coronavirus Humanos. Los nombres de cada gen están indicados. Genes específicos de cada género están en colores claros. Enjuanes et al. 2016. Advances in Virus Research.

Estamos inmersos en una montaña rusa donde las pautas que servían hace tan solo unos días están cambiando rapidísimamente. Y es que nos enfrentamos a algo muy serio, que hace muy complicado ponerse enfermos en la actualidad (especialmente si son nuestros mayores los afectados). Por tanto, cuidaros mucho. Apoyad y apoyaros en todo vuestro entorno. Aprenderemos mucho de esta experiencia, sobre cómo vivir aislados, pero más en contacto que nunca.
Desde luego que vivimos una época excepcional, y como tal debemos de enfrentarnos a ella. Si lo pensamos, y volviendo a nuestro tema común, a nuestro proyecto, a lo mejor hemos tenido doble suerte con este proyecto CRISPR.
Suerte en el hecho de que para participar en este proyecto solo necesitamos:
- Nuestro ordenador.
- Internet.
- Nuestra cabeza.
Respecto a lo último, estoy seguro de que si recordamos un poco, estamos más preparados que nunca para terminar y dar la guinda a este proyecto. Con independencia de cuando tengamos la oportunidad de presentarlo, cosa que no dudéis. Se nos presentará. ¡¡¡Ya veréis!!!
Volviendo a nuestra tarea. Es importante avanzar para que de esta manera cuando volvamos no empecemos de cero.
Si miráis la última entrada, os dije que íbamos a "buscar" CRISPR elements en un genoma no descrito todavía. El genoma de Vibrio vulnificus VV5. En seguida lo recibiréis en vuestro correo. Descargarlo de vuestros ordenadores.
El genoma tiene un tamaño de 5.226.436 nucleótidos (lo podéis abrir desde el Clone Manager). ¡¡¡Está esperando que lo analicemos!!!
Repasad vuestras notas. Quiero que me digáis y lo apuntéis en el blog. Quiero que discutáis por Skype las siguientes cuestiones:
- ¿Hay elementos CRISPR?
- ¿Cuántos?
- ¿Dónde se localizan? ¿Cuáles son sus coordenadas?
Premio al que inserte pantallas en las entradas.

A partir de aquí se generarán nuevas preguntas. ¿Os parece bien que nos sincronicemos semana a semana?
Ánimo, que más pronto que tarde nos veremos de nuevo.

Un saludo y un abrazo.

martes, 11 de febrero de 2020

Noticias y actualidad

El pasado Lunes 10 de Febrero se ha publicado en la prensa esta noticia…


Enlaces varios:
https://elpais.com/elpais/2020/02/10/ciencia/1581359329_317929.html
https://www.mundiario.com/articulo/sociedad/autorizan-modificacion-genes-40-embriones-humanos-cataluna/20200210230024175335.html

Os recomiendo que leáis en detalle esta noticia.

Embriones Humanos (La Vanguardia)

¿Por qué está relacionada con nuestro blog?
¿En qué está basada esta forma de edición génica que proponen en este proyecto?

Como toda investigación siempre es importante que conozcamos de primera mano las posibles repercusiones (aunque sean lejanas) de nuestra propia investigación.

Un saludo y Aupa CRISPR-team.
Nos vemos en breve.

martes, 4 de febrero de 2020

Preparando la nueva cita

Como ya os comenté, ya hemos decidido qué genoma investigar.
Se trata de una colaboración que tenemos con el grupo de la catedrática de Microbiología Carmen Amaro de la Universidad de Valencia.


Carmen es especialista en el estudio de la interacción patógeno/hospedador utilizando el sistema de Vibrio vulnificus y la Anguila como modelo.

Vibrio vulnificus (Sociedad Española de Microbiología)

El genoma que vamos a analizar, no está todavía publicado y vamos a buscar la presencia de sistemas CRISPR en dicho genoma. El aislado se denomina VV5.

La nueva sesión, la dedicaremos por entero al estudio de este genoma!!!!
Y recordaremos y ahondaremos en el estudio de la herramienta CRISPR-Target: 

Aupa equipo, ya estamos cerca.

Estas son las fechas clave en la Organización de nuestra investigación.

PIIISA 2019/2020 en la Estación Experimental del Zaidín
Fechas clave:

1ª sesión:      27/11/2019
2ª sesión:      29/01/2020
3ª sesión:      29/04/2020

Congreso en la EEZ: Miércoles, 13 de mayo de 2020
Congreso General: Viernes, 22 de mayo de 2020

¡¡¡Una nueva sesión adicional!!!  ¡¡¡Este mes Febrero!!!  ¡¡¡ nos espera!!!!


Vamos a entender como las bacterias (en este caso V. vulnificus VV5) luchan frente a los virus que las atacan…

Experiencias con el clone manager, y con crispr-finder y con crispr-target…

¡¡¡De nuevo la sensación de estar exhaustos!!! Y es que … ¡¡¡vaya proyecto!!!.

Momentos de la mañana del pasado miércoles 29 (I)

Pasamos de la sorpresa, a la contra-sorpresa, al cansancio, al no me entero de nada, al me entero de todo… y todavía nos quedan desafíos… aunque nos hacemos mayores… ¿no?

Momentos de la mañana del pasado Miercoles 29 (II)

Si repasamos mentalmente lo que hemos hecho, no parece mucho pero si parece mucho … . Así:
(i) Gracias al clone manager:
-Ya sabemos mirar una secuencia de DNA de muchas maneras distintas:
-Desde arriba (dirección 5’ 3’).
-Desde abajo cadena complementaria (y de nuevo dirección 5’-3’).
-Encontrar las verdaderas regiones repetidas y no. Su equivalente complementario.

Imagen 2: Herramienta “invert”

-Aprehender bien lo que significa las siglas ORF. Que dan lugar a cadenas de aminoácidos que permiten una identificación precisa de lo que tenemos entre manos.

Imagen 3: Herramienta ORF search….

(ii) Que en lo que a secuencia de ADN se refiere dos cosas nos definen un locus CRISPR:
-El tándem de las secuencias repetidas (con sus spacers!!!!).
-El conjunto de genes cas asociados!!!

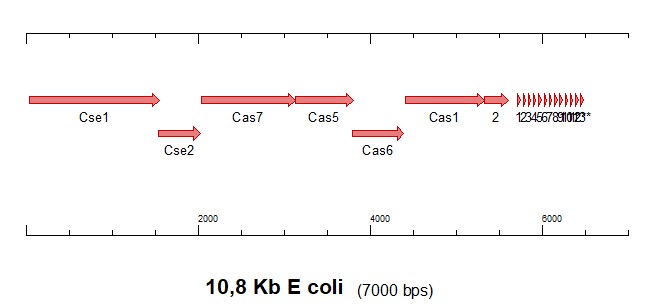
Imagen 4: Determinantes genéticos que nos definen un locus CRISPR

Todo ello nos lleva a unos spacers concretos que son algo así como el record de infecciones que han tenido lugar en una determinada especie de bacteria.

La identificación de los elementos CRISPR se realiza mediante:
Crispr finder en sus dos versiones. Ello nos permite dado un genoma determinado, encontrar dónde se encuentran.

Tenemos cuatro genomas a “investigar”:

Genoma 1: Lactobacillus paracasei strain LC355 (In Atlas of Oral Microbiology, 2015)

Genoma 2: Saccharolobus solfataricus strain P1 (In http://www.sulfosys.com/sulfolobus-solfataricus.html // Federal Ministry of Educational Research (Germany).

Genoma 3: Thermococcus chitonophagus (Imagen obtenida por K.O.Stetter & R.Rachel, Univ.Regensburg).

Genoma 4: Thermodesulfovibrio yellowstonii (Henry et al. 1994 Arch Microbiol. Jan;161(1):62-9).

Os animo a que buceeis por internet y busquéis aspectos de la biología de estos microorganimos. De donde se han aislado, que características tienen, etc…
Como os digo, debemos de confirmar y entender que los genomas que vamos a estudiar contienen:
Lactobacillus paracasei strain LC355. Un array sin proteínas
Saccharolobus solfataricus strain P1. 8 arrays confirmados y 5 sistemas crispr distintos
Thermococcus chitonophagus. 8 arrays y 5 sistemas crispR
Thermodesulfovibrio yellowstonii 5 arrays y 5 sistemas crispr

Inicialmente hay que subir los genomas a esta base de datos:
https://crisprcas.i2bc.paris-saclay.fr/

Para después lanzarle la pregunta de dónde están sus sistemas crispr.


Probad los distintos genomas y comentad lo que sale. Preguntaros y recordar el cómo entre vosotros y a través del Blog. Practicad con el clone manager e identificar las regiones conteniendo estos sistemas…

viernes, 13 de diciembre de 2019

Aprendiendo a identificar Sistemas CRISPR (III)

Si ya hemos practicado un poco con las secuencias anteriores, deberíamos entender que una secuencia de nucleótidos precisa tiene un gran valor identificativo. Por ello, podemos deducir que gran parte del manejo del programa (Clonemanger) se basa en buscar secuencias concretas, alinearlas de manera parecida, etc.  Y esas son herramientas que nos ayudarán a definir y entender cómo se logra encontrar un sistema CRISPR en una secuencia de nucleótidos,  que como todos sabemos se trata de:  
“Clustered Regularly Interspaced Short Palindromic Repeats” 

O sea, grupos de secuencias cortas (20-40 nt) repetidas generalmente palindrómicas interespaciadas de manera regular (a distancias entre 30-70 nt).

Recordando, atendiendo y practicando las explicaciones del pasado Jueves 5 de Diciembre

Para identificar de manera rápida este tipo de “estructuras” en una secuencia de DNA existe una página web denominada: crispr finder (https://crispr.i2bc.paris-saclay.fr/Server/). Os animo a que entréis:

Y subáis el documento que tenéis en la carpeta 2-E coli denominado E coli.txt (que “pesa” 4596 KB). Y “clickeis” en Find crispr
Os debe de salir algo así: 


Que debemos saber (y recordar) qué significan:


Con esta información deberíamos de saber, crear y modificar un documento de clone manager. De tal manera que partiendo de:
Una secuencia de este tipo:
 La convirtamos inicialmente en una secuencia de este tipo: 
Para ello habrá que utilizar la herramienta add feature seleccionando en cada caso la secuencia que queremos “dibujar”. En este caso deberéis de ayudar a los que no estuvieron, y hacer un poco de memoria de cómo lo hicimos ese Jueves, clave!!! … (consultar el tutorial del programa por si sirve de ayuda, usad el blog, cargarlo de preguntas, etc… ).


Finalmente, acompañando a estos sistemas repetidos, casi siempre se encuentran grupos de genes asociados, los denominados genes “Cas”. El clone manager nos va a permitir identificarlos, “dibujarlos”, definirlos y en resumen entender en qué consisten. 

Se trata de que debemos de convertir esta información:

En esta otra:

Donde se identifican los marcos abiertos de lectura (ORFs) que codifican las proteínas que acompañan el elemento CRISPR (con 13 repeticiones directas) y que hacen funcional todo un sistema de defensa inmune en bacterias.

Es sólo (y no tan sólo, soy consciente) de ponernos un rato y “entender” toda la información extraíble de una mera secuencia de cuatro letras: la A, la T, la C y la G… .
Ánimo que veréis como podéis (podemos). Activemos el blog con comentarios/preguntas, que estoy seguro que no sólo hay una sino mil….
Ya tenemos tarea!!!!...

jueves, 12 de diciembre de 2019

Aprendiendo a identificar Sistemas CRISPR (II)

Ya hemos dado nuestros primeros pasos con el programa Clonemanager (podemos encontrar más información sobre su manejo en los tutoriales que se encuentran en la carpeta del programa: S8Guide1 y S8Guide2). Hemos entendido que la información del DNA se basa en un código de 4 letras (GATC) y que esa secuencia, tiene un gran valor identificativo. Pero …, sabemos que esa secuencia “esconde” genes. (ver las presentaciones en recursos). 
Y es que, los genes al final de cuentas son en su mayoría proteínas, esto es secuencias de aminoácidos. Además gracias al código genético universal, tener una secuencia de nucleótidos (GATC…) es equivalente a tener una secuencia de aminoácidos, o sea un gen.


El código genético Universal

Todos tenemos que tener un ruleta parecida… (La tenemos, verdad??) en la que como vemos los aminoácidos están codificados en tripletes de nucleótidos… 
Os propongo un ejercicio que no es otro que me digáis las 6 secuencias de aminoácidos codificados en estos 20 nucleótidos:
ATGTACGTAATACTGGTATA

“Un premio al que lo diga primero en comentarios (podeis consultarlo ente vosotros…)”. Y lo incluís en comentarios de este Blog!!! Mejor Hoy que mañana!!!”

Podéis hacerlo en un cuaderno usando la plantilla y ruleta. Es un buen ejercicio, pero si recordáis un poco (o consultáis con los que estuvieron), la herramienta Clonemanager os puede ayudar en la tarea. Desde varias opciones:
(i) Usando la herramienta format y cambiando la información de secuencia de manera que incluya la traducción (translate) de la secuencia de DNA…

(ii) Usando la herramienta “Process molecule” y traduciendo…

Porque el programa nos permite identificar lo que se conoce como marcos abiertos de lectura (en ingles Open Reading Frame; lo recordáis, os suena, etc….
Os recomiendo el nuevo ejercicio:
“Abrid desde el clone manager el Archivo 1-20 kb dentro de la carpeta de ejercicios:  3-ORF”.
Tenéis que entender cómo el programa ha encontrado esos Marcos Abiertos de Lectura (ORFs) mediante la herramienta ORF search:

Encontrando al menos 7 marcos abiertos de lectura que “codifican a 7 secuencias de proteína respectivas.

¿Quién me dice el número de aminoácidos de cada uno de ellas (la más grande, la más chica, … (el listado de todas ellas…)?

¡¡¡Quiero el blog lleno de dudas, comentarios, etc...!!!

Tras estos ejercicios y un poco de práctica estamos ya preparados para “enfrentarnos a la identificación de los sistemas CRISPR.
Aupa Team, estamos en la senda!!! 

martes, 10 de diciembre de 2019

Aprendiendo a identificar los Sistemas CRISPR (I)

Ya estamos en el camino de convertirnos en unos expertos buscadores de sistemas CRISPR en los  genomas de bacterias… ¿O no?

Caras sonrientes de alumnos y algún padre (Pedro y Raúl) tras la dura sesión del pasado Jueves.

Parece fácil, una vez lo conoces, parece evidente…  Pero, no hay que olvidar que lo que hicimos el pasado Jueves en una sesión de unas 3 h les llevo a los investigadores casi 10 años caer en la cuenta de lo que estaban analizando (os animo a que le echéis un vistazo a este artículo subido en recursos: Mojica FJ, Rodriguez-Valera F. The discovery of CRISPR in archaea and bacteria. FEBS J. 2016 Sep; 283(17):3162-9); (Ver imagen 2).  Seamos conscientes de ello. 


Qué fue lo que hicimos exactamente:
Lo primero fue recordar y ya centrarnos en los objetivos de nuestro proyecto (ver presentación 2º dia en recursos) que aunque se parece mucho a la del primer día, ya nos focalizamos en el manejo de nuestro programa que nos va a acompañar a lo largo de todo nuestro proyecto: el clone manager. 
Tres de vosotros ya los tenéis en vuestros portátiles y estáis encargados de pasarlo a los demás que no pudieron asistir así como de reuniros con ellos y realizar los ejercicios que se irán proponiendo desde este blog. Deberíamos de ser capaces de transmitirles todo lo que aprendimos y se debatió el pasado Jueves. Seguro que podemos!!!
Todos tenéis en vuestros portátiles una carpeta que se llamaba Copiar 1 (que contiene la carpeta clonemanager8 para instalar el programa, que simplemente hay que abrir el ejecutable: CmSuite8.exe en el que aparecerá la imagen de trabajo del programa:


A partir de ahí deberemos de practicar las distintas funciones que ejecutamos…
Para manejar el programa habrá que darle un click a “close”. Y darle a abrir Inicialmente sobre la carpeta Problema 1. Abriendo la secuencia que pone primera: 16SrRNA-1 (una secuencia de nucleótidos que nos servirá de ejemplo para entender cómo funciona este programa) abrir también las demás carpetas, A, B, … F)
A partir de aquí os queda “recordar” muchas de las cosas que llevamos a cabo:
- Visualizar una secuencia determinada (open).
- Cambiar la visualización a doble hebra (format). 
- Realizar una copia inversa (Operations: Process molecule: inverse…).
Entender la “direccionalidad” del ADN (que es el extremo 5’ y el extremo 3’). Entender que es la inversa de una cadena de DNA. Entender que, aunque solo tengamos una hebra, “siempre hay dos”.
Para ello usaremos las herramientas Align and Compare entre las secuencias de la carpeta (de la A a la F) y entenderemos sus parecidos y/o diferencias. Os animo a que las practiquéis en casa y las recordéis con vuestros compañeros que no pudieron venir.


En una próxima entrada, Cuando nos aseguremos que todos tenemos en nuestros ordenadores el programa Clone Manager, seguiremos recordando todo lo que hicimos!!!!
(Os anticipo…  qué es un gen? Cómo se analiza??)

Aupa Team…. Ya estamos acercándonos a nuestro objetivo!!!!

Entradas más visitadas